
Python併發程式設計(執行緒,Threading模組,守護執行緒,gil鎖,)
一 背景知識
之前我們已經瞭解了作業系統中程序的概念,程式並不能單獨執行,只有將程式裝載到記憶體中,系統為它分配資源才能執行,而這種執行的程式就稱之為程序。程式和程序的區別就在於:程式是指令的集合,它是程序執行的靜態描述文字;程序是程式的一次執行活動,屬於動態概念。在多道程式設計中,我們允許多個程式同時載入到記憶體中,在作業系統的排程下,可以實現併發地執行。這是這樣的設計,大大提高了CPU的利用率。程序的出現讓每個使用者感覺到自己獨享CPU,因此,程序就是為了在CPU上實現多道程式設計而提出的。
2.有了程序為什麼還要執行緒
#什麼是執行緒:
#指的是一條流水線的工作過程,關鍵的一句話:一個程序內最少自帶一個執行緒,其實程序根本不能執行,程序不是執行單位,是資源的單位,分配資源的單位
#執行緒才是執行單位
#程序:做手機螢幕的工作過程,剛才講的
#我們的py檔案在執行的時候,如果你站在資源單位的角度來看,我們稱為一個主程序,如果站在程式碼執行的角度來看,它叫做主執行緒,只是一種形象的說法,其實整個程式碼的執行過程成為執行緒,也就是幹這個活兒的本身稱為執行緒,但是我們後面學習的時候,我們就稱為執行緒去執行某個任務,其實那某個任務的執行過程稱為一個執行緒,一條流水線的執行過程為執行緒

#程序vs執行緒
#1 同一個程序內的多個執行緒是共享該程序的資源的,不同程序內的執行緒資源肯定是隔離的
#2 建立執行緒的開銷比建立程序的開銷要小的多


#併發三個任務:1啟動三個程序:因為每個程序中有一個執行緒,但是我一個程序中開啟三個執行緒就夠了
#同一個程式中的三個任務需要執行,你是用三個程序好 ,還是三個執行緒好?
#例子:
    # pycharm 三個任務:鍵盤輸入  螢幕輸出  自動儲存到硬碟
    #如果三個任務是同步的話,你鍵盤輸入的時候,螢幕看不到
    #咱們的pycharm是不是一邊輸入你邊看啊,就是將序列變為了三個併發的任務
    #解決方案:三個程序或者三個執行緒,哪個方案可行。如果是三個程序,程序的資源是不是隔離的並且開銷大,最致命的就是資源隔離,但是使用者輸入的資料還要給另外一個程序傳送過去,程序之間能直接給資料嗎?你是不是copy一份給他或者通訊啊,但是資料是同一份,我們有必要搞多個程序嗎,執行緒是不是共享資源的,我們是不是可以使用多執行緒來搞,你執行緒1輸入的資料,執行緒2能不能看到,你以後的場景還是應用多執行緒多,而且起執行緒我們說是不是很快啊,佔用資源也小,還能共享同一個程序的資源,不需要將資料來回的copy!
程序有很多優點,它提供了多道程式設計,讓我們感覺我們每個人都擁有自己的CPU和其他資源,可以提高計算機的利用率。很多人就不理解了,既然程序這麼優秀,為什麼還要執行緒呢?其實,仔細觀察就會發現程序還是有很多缺陷的,主要體現在兩點上:
-
-
程序只能在一個時間幹一件事,如果想同時幹兩件事或多件事,程序就無能為力了。
-
程序在執行的過程中如果阻塞,例如等待輸入,整個程序就會掛起,即使程序中有些工作不依賴於輸入的資料,也將無法執行。
-
如果這兩個缺點理解比較困難的話,舉個現實的例子也許你就清楚了:如果把我們上課的過程看成一個程序的話,那麼我們要做的是耳朵聽老師講課,手上還要記筆記,腦子還要思考問題,這樣才能高效的完成聽課的任務。而如果只提供程序這個機制的話,上面這三件事將不能同時執行,同一時間只能做一件事,聽的時候就不能記筆記,也不能用腦子思考,這是其一;如果老師在黑板上寫演算過程,我們開始記筆記,而老師突然有一步推不下去了,阻塞住了,他在那邊思考著,而我們呢,也不能幹其他事,即使你想趁此時思考一下剛才沒聽懂的一個問題都不行,這是其二。
現在你應該明白了程序的缺陷了,而解決的辦法很簡單,我們完全可以讓聽、寫、思三個獨立的過程,並行起來,這樣很明顯可以提高聽課的效率。而實際的作業系統中,也同樣引入了這種類似的機制——執行緒。
3.執行緒的出現
在傳統作業系統中,每個程序有一個地址空間,而且預設就有一個控制執行緒
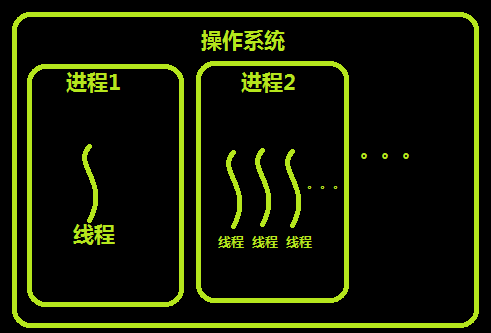
執行緒顧名思義,就是一條流水線工作的過程,一條流水線必須屬於一個車間,一個車間的工作過程是一個程序
車間負責把資源整合到一起,是一個資源單位,而一個車間內至少有一個流水線
流水線的工作需要電源,電源就相當於cpu
所以,程序只是用來把資源集中到一起(程序只是一個資源單位,或者說資源集合),而執行緒才是cpu上的執行單位。
多執行緒(即多個控制執行緒)的概念是,在一個程序中存在多個控制執行緒,多個控制執行緒共享該程序的地址空間,相當於一個車間內有多條流水線,都共用一個車間的資源。
例如,北京地鐵與上海地鐵是不同的程序,而北京地鐵裡的13號線是一個執行緒,北京地鐵所有的線路共享北京地鐵所有的資源,比如所有的乘客可以被所有線路拉。
二 程序和執行緒的關係
三 執行緒的特點
TCB包括以下資訊:
(1)執行緒狀態。
(2)當執行緒不執行時,被儲存的現場資源。
(3)一組執行堆疊。
(4)存放每個執行緒的區域性變數主存區。
(5)訪問同一個程序中的主存和其它資源。
用於指示被執行指令序列的程式計數器、保留區域性變數、少數狀態引數和返回地址等的一組暫存器和堆疊。
四 執行緒的實際應用場景
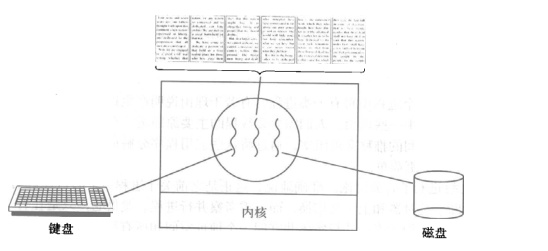
開啟一個字處理軟體程序,該程序肯定需要辦不止一件事情,比如監聽鍵盤輸入,處理文字,定時自動將文字儲存到硬碟,這三個任務操作的都是同一塊資料,因而不能用多程序。只能在一個程序裡併發地開啟三個執行緒,如果是單執行緒,那就只能是,鍵盤輸入時,不能處理文字和自動儲存,自動儲存時又不能輸入和處理文字。
之前我們將的socket是不是通過多程序去實現過呀,如果有500個人同時和我聊天,那我是不是要起500程序啊,能行嗎?不好,對不對,那麼怎麼辦,我就可以開幾個程序,然後每個程序裡面開多個執行緒來處理多個請求和通訊。再舉例:我用qq是一個程序,然後我和一個人聊天的時候,是不是還可以去接收別人給我發的訊息啊,這個是不是並行的啊,就類似我一個程序開了多個執行緒來幫我併發接收訊息。
五 記憶體中的執行緒

多個執行緒共享同一個程序的地址空間中的資源,是對一臺計算機上多個程序的模擬,有時也稱執行緒為輕量級的程序。
而對一臺計算機上多個程序,則共享實體記憶體、磁碟、印表機等其他物理資源。多執行緒的執行也多程序的執行類似,是cpu在多個執行緒之間的快速切換。
不同的程序之間是充滿敵意的,彼此是搶佔、競爭cpu的關係,如果迅雷會和QQ搶資源。而同一個程序是由一個程式設計師的程式建立,所以同一程序內的執行緒是合作關係,一個執行緒可以訪問另外一個執行緒的記憶體地址,大家都是共享的,一個執行緒乾死了另外一個執行緒的記憶體,那純屬程式設計師腦子有問題。
類似於程序,每個執行緒也有自己的堆疊,不同於程序,執行緒庫無法利用時鐘中斷強制執行緒讓出CPU,可以呼叫thread_yield執行執行緒自動放棄cpu,讓另外一個執行緒執行。
執行緒通常是有益的,但是帶來了不小程式設計難度,執行緒的問題是:
1. 父程序有多個執行緒,那麼開啟的子執行緒是否需要同樣多的執行緒
2. 在同一個程序中,如果一個執行緒關閉了檔案,而另外一個執行緒正準備往該檔案內寫內容呢?
因此,在多執行緒的程式碼中,需要更多的心思來設計程式的邏輯、保護程式的資料。
六 使用者級執行緒和核心級執行緒(瞭解)
執行緒的實現可以分為兩類:使用者級執行緒(User-Level Thread)和核心線執行緒(Kernel-Level Thread),後者又稱為核心支援的執行緒或輕量級程序。在多執行緒作業系統中,各個系統的實現方式並不相同,在有的系統中實現了使用者級執行緒,有的系統中實現了核心級執行緒。
1.使用者級執行緒
核心的切換由使用者態程式自己控制核心切換,不需要核心干涉,少了進出核心態的消耗,但不能很好的利用多核Cpu。
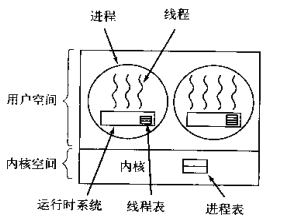
在使用者空間模擬作業系統對程序的排程,來呼叫一個程序中的執行緒,每個程序中都會有一個執行時系統,用來排程執行緒。此時當該程序獲取cpu時,程序內再排程出一個執行緒去執行,同一時刻只有一個執行緒執行。
2.核心級執行緒
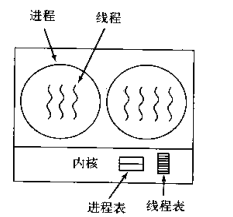
核心級執行緒:切換由核心控制,當執行緒進行切換的時候,由使用者態轉化為核心態。切換完畢要從核心態返回使用者態;可以很好的利用smp,即利用多核cpu。windows執行緒就是這樣的。
3.使用者級和核心級執行緒的對比
1 核心支援執行緒是OS核心可感知的,而使用者級執行緒是OS核心不可感知的。
2 使用者級執行緒的建立、撤消和排程不需要OS核心的支援,是在語言(如Java)這一級處理的;而核心支援執行緒的建立、撤消和排程都需OS核心提供支援,而且與程序的建立、撤消和排程大體是相同的。
3 使用者級執行緒執行系統呼叫指令時將導致其所屬程序被中斷,而核心支援執行緒執行系統呼叫指令時,只導致該執行緒被中斷。
4 在只有使用者級執行緒的系統內,CPU排程還是以程序為單位,處於執行狀態的程序中的多個執行緒,由使用者程式控制執行緒的輪換執行;在有核心支援執行緒的系統內,CPU排程則以執行緒為單位,由OS的執行緒排程程式負責執行緒的排程。
5 使用者級執行緒的程式實體是執行在使用者態下的程式,而核心支援執行緒的程式實體則是可以執行在任何狀態下的程式
核心級執行緒的優缺點:
優點:當有多個處理機時,一個程序的多個執行緒可以同時執行。
缺點:由核心進行排程
使用者級執行緒的優缺點:
優點:
  執行緒的排程不需要核心直接參與,控制簡單。
  可以在不支援執行緒的作業系統中實現。
  建立和銷燬執行緒、執行緒切換代價等執行緒管理的代價比核心執行緒少得多。
  允許每個程序定製自己的排程演算法,執行緒管理比較靈活。
  執行緒能夠利用的表空間和堆疊空間比核心級執行緒多。
  同一程序中只能同時有一個執行緒在執行,如果有一個執行緒使用了系統呼叫而阻塞,那麼整個程序都會被掛起。另外,頁面失效也會產生同樣的問題。
缺點:
  資源排程按照程序進行,多個處理機下,同一個程序中的執行緒只能在同一個處理機下分時複用
3.混合實現
使用者級與核心級的多路複用,核心同一排程核心執行緒,每個核心執行緒對應n個使用者執行緒,使用者和核心都能感知到的執行緒,使用者建立一個執行緒,那麼作業系統核心也跟著建立一個執行緒來專門執行你使用者的這個執行緒。
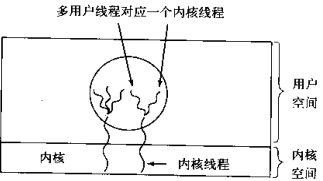
在linux作業系統上也實現了這種混合的方式NPTL,看下面的介紹。
4.linux作業系統的NPTL
歷史
在核心2.6以前的排程實體都是程序,核心並沒有真正支援執行緒。它是能過一個系統呼叫clone()來實現的,這個呼叫建立了一份呼叫程序的拷貝,跟fork()不同的是,這份程序拷貝完全共享了呼叫程序的地址空間。LinuxThread就是通過這個系統呼叫來提供執行緒在核心級的支援的(許多以前的執行緒實現都完全是在使用者態,核心根本不知道執行緒的存在)。非常不幸的是,這種方法有相當多的地方沒有遵循POSIX標準,特別是在訊號處理,排程,程序間通訊原語等方面。

很顯然,為了改進LinuxThread必須得到核心的支援,並且需要重寫執行緒庫。為了實現這個需求,開始有兩個相互競爭的專案:IBM啟動的NGTP(Next Generation POSIX Threads)專案,以及Redhat公司的NPTL。在2003年的年中,IBM放棄了NGTP,也就是大約那時,Redhat釋出了最初的NPTL。

NPTL最開始在redhat linux 9裡釋出,現在從RHEL3起核心2.6起都支援NPTL,並且完全成了GNU C庫的一部分。


設計
NPTL使用了跟LinuxThread相同的辦法,在核心裡面執行緒仍然被當作是一個程序,並且仍然使用了clone()系統呼叫(在NPTL庫裡呼叫)。但是,NPTL需要核心級的特殊支援來實現,比如需要掛起然後再喚醒執行緒的執行緒同步原語futex.

NPTL也是一個1*1的執行緒庫,就是說,當你使用pthread_create()呼叫建立一個執行緒後,在核心裡就相應建立了一個排程實體,在linux裡就是一個新程序,這個方法最大可能的簡化了執行緒的實現。

除NPTL的1*1模型外還有一個m*n模型,通常這種模型的使用者執行緒數會比核心的排程實體多。在這種實現裡,執行緒庫本身必須去處理可能存在的排程,這樣線上程庫內部的上下文切換通常都會相當的快,因為它避免了系統呼叫轉到核心態。然而這種模型增加了執行緒實現的複雜性,並可能出現諸如優先順序反轉的問題,此外,使用者態的排程如何跟核心態的排程進行協調也是很難讓人滿意。
七 python與執行緒
1.全域性直譯器鎖GIL(用一下threading模組之後再來看~~)
Python程式碼的執行由Python虛擬機器(也叫直譯器主迴圈)來控制。Python在設計之初就考慮到要在主迴圈中,同時只有一個執行緒在執行。雖然 Python 直譯器中可以“執行”多個執行緒,但在任意時刻只有一個執行緒在直譯器中執行。
對Python虛擬機器的訪問由全域性直譯器鎖(GIL)來控制,正是這個鎖能保證同一時刻只有一個執行緒在執行。
在多執行緒環境中,Python 虛擬機器按以下方式執行:
a、設定 GIL;
b、切換到一個執行緒去執行;
c、執行指定數量的位元組碼指令或者執行緒主動讓出控制(可以呼叫 time.sleep(0));
d、把執行緒設定為睡眠狀態;
e、解鎖 GIL;
d、再次重複以上所有步驟。
在呼叫外部程式碼(如 C/C++擴充套件函式)的時候,GIL將會被鎖定,直到這個函式結束為止(由於在這期間沒有Python的位元組碼被執行,所以不會做執行緒切換)編寫擴充套件的程式設計師可以主動解鎖GIL。
2.python執行緒模組的選擇
Python提供了幾個用於多執行緒程式設計的模組,包括thread、threading和Queue等。thread和threading模組允許程式設計師建立和管理執行緒。thread模組提供了基本的執行緒和鎖的支援,threading提供了更高級別、功能更強的執行緒管理的功能。Queue模組允許使用者建立一個可以用於多個執行緒之間共享資料的佇列資料結構。
避免使用thread模組,因為更高級別的threading模組更為先進,對執行緒的支援更為完善,而且使用thread模組裡的屬性有可能會與threading出現衝突;其次低級別的thread模組的同步原語很少(實際上只有一個),而threading模組則有很多;再者,thread模組中當主執行緒結束時,所有的執行緒都會被強制結束掉,沒有警告也不會有正常的清除工作,至少threading模組能確保重要的子執行緒退出後進程才退出。
就像我們熟悉的time模組,它比其他模組更加接近底層,越是接近底層,用起來越麻煩,就像時間日期轉換之類的就比較麻煩,但是後面我們會學到一個datetime模組,提供了更為簡便的時間日期處理方法,它是建立在time模組的基礎上來的。又如socket和socketserver(底層還是用的socket)等等,這裡的threading就是thread的高階模組。
thread模組不支援守護執行緒,當主執行緒退出時,所有的子執行緒不論它們是否還在工作,都會被強行退出。而threading模組支援守護執行緒,守護執行緒一般是一個等待客戶請求的伺服器,如果沒有客戶提出請求它就在那等著,如果設定一個執行緒為守護執行緒,就表示這個執行緒是不重要的,在程序退出的時候,不用等待這個執行緒退出。
Threading模組
multiprocess模組的完全模仿了threading模組的介面,二者在使用層面,有很大的相似性,因而不再詳細介紹(官方連結)
我們先簡單應用一下threading模組來看看併發效果:
import time
from threading import Thread
#多執行緒併發,是不是看著和多程序很類似
def func(n):
    time.sleep(1)
    print(n)

#併發效果,1秒打印出了所有的數字
for i in range(10):
    t = Thread(target=func,args=(i,))
    t.start()
1.執行緒建立
from threading import Thread
import time
def sayhi(name):
    time.sleep(2)
    print('%s say hello' %name)

if __name__ == '__main__':
    t=Thread(target=sayhi,args=('太白',))
    t.start()
    print('主執行緒')

方式1
import time
from threading import Thread
class Sayhi(Thread):
    def __init__(self,name):
        super().__init__()
        self.name=name
    def run(self):
        time.sleep(2)
        print('%s say hello' % self.name)


if __name__ == '__main__':
    t = Sayhi('太白')
    t.start()
    print('主執行緒')

方式2
2.多執行緒與多程序
from threading import Thread
from multiprocessing import Process
import os

def work():
    print('hello',os.getpid())

if __name__ == '__main__':
    #part1:在主程序下開啟多個執行緒,每個執行緒都跟主程序的pid一樣
    t1=Thread(target=work)
    t2=Thread(target=work)
    t1.start()
    t2.start()
    print('主執行緒/主程序pid',os.getpid())

    #part2:開多個程序,每個程序都有不同的pid
    p1=Process(target=work)
    p2=Process(target=work)
    p1.start()
    p2.start()
    print('主執行緒/主程序pid',os.getpid())


pid(程序id)
那麼哪些東西存在程序裡,那些東西存線上程裡呢?
程序:匯入的模組、執行的python檔案的檔案所在位置、內建的函式、檔案裡面的這些程式碼、全域性變數等等,然後執行緒裡面有自己的堆疊(類似於一個列表,後進先出)和暫存器,裡面存著自己執行緒的變數,操作(add)等等,佔用的空間很小。
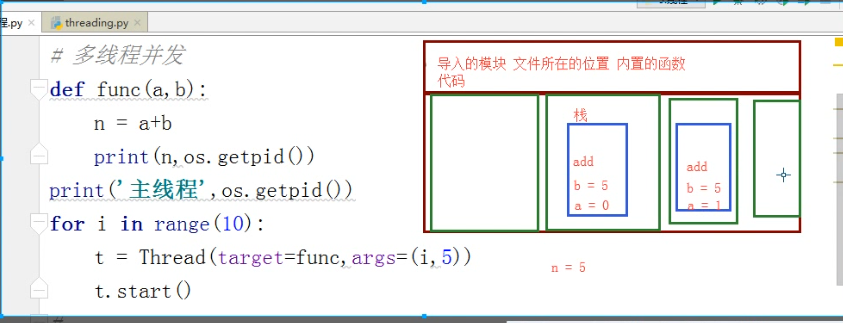
from threading import Thread
from multiprocessing import Process
import os
import time
def work():
    print('hello')

if __name__ == '__main__':
    s1 = time.time()
    #在主程序下開啟執行緒
    t=Thread(target=work)
    t.start()
    t.join()
    t1 = time.time() - s1
    print('程序的執行時間:',t1)
    print('主執行緒/主程序')
    '''
    列印結果:
    hello
    程序的執行時間: 0.0
    主執行緒/主程序
    '''

    s2 = time.time()
    #在主程序下開啟子程序
    t=Process(target=work)
    t.start()
    t.join()
    t2 = time.time() - s2
    print('執行緒的執行時間:', t2)
    print('主執行緒/主程序')
    '''
    列印結果:
    hello
    執行緒的執行時間: 0.5216977596282959
    主執行緒/主程序
    '''

程序與執行緒開啟效率比較
from  threading import Thread
from multiprocessing import Process
import os
def work():
    global n  #修改全域性變數的值
    n=0

if __name__ == '__main__':
    # n=100
    # p=Process(target=work)
    # p.start()
    # p.join()
    # print('主',n) #毫無疑問子程序p已經將自己的全域性的n改成了0,但改的僅僅是它自己的,檢視父程序的n仍然為100


    n=1
    t=Thread(target=work)
    t.start()
    t.join()   #必須加join,因為主執行緒和子執行緒不一定誰快,一般都是主執行緒快一些,所有我們要等子執行緒執行完畢才能看出效果
    print('主',n) #檢視結果為0,因為同一程序內的執行緒之間共享程序內的資料
# 通過一個global就實現了全域性變數的使用,不需要程序的IPC通訊方法

記憶體資料共享
在這裡我們簡單總結一下:
程序是最小的記憶體分配單位
執行緒是作業系統排程的最小黨委
執行緒被CPU執行了
程序內至少含有一個執行緒
程序中可以開啟多個執行緒
開啟一個執行緒所需要的時間要遠小於開啟一個程序
多個執行緒內部有自己的資料棧,資料不共享
全域性變數在多個執行緒之間是共享的
3.多執行緒實現socket(練習)
import multiprocessing
import threading

import socket
s=socket.socket(socket.AF_INET,socket.SOCK_STREAM)
s.bind(('127.0.0.1',8080))
s.listen(5)

def action(conn):
    while True:
        data=conn.recv(1024)
        print(data)
        msg = input('服務端輸入:') #在多執行緒裡面可以使用input輸入內容,那麼就可以實現客戶端和服務端的聊天了,多程序不能輸入
        conn.send(bytes(msg,encoding='utf-8'))

if __name__ == '__main__':

    while True:
        conn,addr=s.accept()
        p=threading.Thread(target=action,args=(conn,))
        p.start()

tcp_server.py
講一講程式碼
mport socket

s=socket.socket(socket.AF_INET,socket.SOCK_STREAM)
s.connect(('127.0.0.1',8080))

while True:
    msg=input('>>: ').strip()
    if not msg:continue

    s.send(msg.encode('utf-8'))
    data=s.recv(1024)
    print(data)

tcp_client.py
在socket通訊裡面是不是有大量的I/O啊,recv、accept等等,我們使用多執行緒效率更高,因為開銷小。
4.Thread類的其他方法
Thread例項物件的方法
  # isAlive(): 返回執行緒是否活動的。
  # getName(): 返回執行緒名。
  # setName(): 設定執行緒名。

threading模組提供的一些方法:
  # threading.currentThread(): 返回當前的執行緒變數。
  # threading.enumerate(): 返回一個包含正在執行的執行緒的list。正在執行指執行緒啟動後、結束前,不包括啟動前和終止後的執行緒。
  # threading.activeCount(): 返回正在執行的執行緒數量,與len(threading.enumerate())有相同的結果

其他方法
from threading import Thread
import threading
from multiprocessing import Process
import os

def work():
    import time
    time.sleep(3)
    print(threading.current_thread().getName())

if __name__ == '__main__':
    #在主程序下開啟執行緒
    t=Thread(target=work)
    t.start()

    print(threading.current_thread())#主執行緒物件
    print(threading.current_thread().getName()) #主執行緒名稱
    print(threading.current_thread().ident) #主執行緒ID
    print(threading.get_ident()) #主執行緒ID
    print(threading.enumerate()) #連同主執行緒在內有兩個執行的執行緒
    print(threading.active_count())
    print('主執行緒/主程序')

    '''
    列印結果:
    <_MainThread(MainThread, started 14104)>
    MainThread
    14104
    [<_MainThread(MainThread, started 14104)>, <Thread(Thread-1, started 17976)>]
    主執行緒/主程序
    Thread-1
    '''

程式碼示例
from threading import Thread
import time
def sayhi(name):
    time.sleep(2)
    print('%s say hello' %name)

if __name__ == '__main__':
    t=Thread(target=sayhi,args=('太白',))
    t2=Thread(target=sayhi,args=('alex',))
    t.start()
    t2.start()
    t.join()  #因為這個執行緒用了join方法,主執行緒等待子執行緒的執行結束

    print('主執行緒')
    print(t.is_alive())  #所以t這個執行緒肯定是執行結束了,結果為False
    print(t2.is_alive()) #有可能是True,有可能是False,看子執行緒和主執行緒誰執行的快
    '''
    egon say hello
    主執行緒
    False
    '''

join方法
5.守護執行緒
無論是程序還是執行緒,都遵循:守護xx會等待主xx執行完畢後被銷燬。需要強調的是:執行完畢並非終止執行
#1.對主程序來說,執行完畢指的是主程序程式碼執行完畢
#2.對主執行緒來說,執行完畢指的是主執行緒所在的程序內所有非守護執行緒統統執行完畢,主執行緒才算執行完畢
from threading import Thread
import time
def sayhi(name):
    time.sleep(2)
    print('%s say hello' %name)

if __name__ == '__main__':
    t=Thread(target=sayhi,args=('taibai',))
    t.setDaemon(True) #必須在t.start()之前設定
    t.start()

    print('主執行緒')
    print(t.is_alive())
    '''
    主執行緒
    True
    '''

守護執行緒示例1
from threading import Thread
from multiprocessing import Process
import time
def func1():
    while True:
        print(666)
        time.sleep(0.5)
def func2():
    print('hello')
    time.sleep(3)

if __name__ == '__main__':
    # t = Thread(target=func1,)
    # t.daemon = True  #主執行緒結束,守護執行緒隨之結束
    # # t.setDaemon(True) #兩種方式,和上面設定守護執行緒是一樣的
    # t.start()
    # t2 = Thread(target=func2,) #這個子執行緒要執行3秒,主執行緒的程式碼雖然執行完了,但是一直等著子執行緒的任務執行完畢,主執行緒才算完畢,因為通過結果你會發現我主執行緒雖然程式碼執行完畢了,\
    # 但是主執行緒的的守護執行緒t1還在執行,說明什麼,說明我的主執行緒還沒有完畢,只不過是程式碼執行完了,一直等著子執行緒t2執行完畢,我主執行緒的守護執行緒才停止,說明子執行緒執行完畢之後,我的主執行緒才執行完畢
    # t2.start()
    # print('主執行緒程式碼執行完啦!')
    p = Process(target=func1,)
    p.daemon = True
    p.start()

    p2 = Process(target=func2,)
    p2.start()
    time.sleep(1) #讓主程序等1秒,為了能看到func1的列印效果
    print('主程序程式碼執行完啦!') #通過結果你會發現,如果主程序的程式碼執行完畢了,那麼主程序就結束了,因為主程序的守護程序p隨著主程序的程式碼結束而結束了,守護程序被回收了,這和執行緒是不一樣的,主執行緒的程式碼完了並不代表主執行緒執行完畢了,需要等著所有其他的非守護的子執行緒執行完畢才算完畢

守護執行緒示例2
鎖
1.GIL鎖(Global Interpreter Lock)
首先,一些語言(java、c++、c)是支援同一個程序中的多個執行緒是可以應用多核CPU的,也就是我們會聽到的現在4核8核這種多核CPU技術的牛逼之處。那麼我們之前說過應用多程序的時候如果有共享資料是不是會出現資料不安全的問題啊,就是多個程序同時一個檔案中去搶這個資料,大家都把這個資料改了,但是還沒來得及去更新到原來的檔案中,就被其他程序也計算了,導致資料不安全的問題啊,所以我們是不是通過加鎖可以解決啊,多執行緒大家想一下是不是一樣的,併發執行就是有這個問題。但是python最早期的時候對於多執行緒也加鎖,但是python比較極端的(在當時電腦cpu確實只有1核)加了一個GIL全域性解釋鎖,是直譯器級別的,鎖的是整個執行緒,而不是執行緒裡面的某些資料操作,每次只能有一個執行緒使用cpu,也就說多執行緒用不了多核,但是他不是python語言的問題,是CPython直譯器的特性,如果用Jpython直譯器是沒有這個問題的,Cpython是預設的,因為速度快,Jpython是java開發的,在Cpython裡面就是沒辦法用多核,這是python的弊病,歷史問題,雖然眾多python團隊的大神在致力於改變這個情況,但是暫沒有解決。(這和解釋型語言(python,php)和編譯型語言有關係嗎???待定!,編譯型語言一般在編譯的過程中就幫你分配好了,解釋型要邊解釋邊執行,所以為了防止出現數據不安全的情況加上了這個鎖,這是所有解釋型語言的弊端??)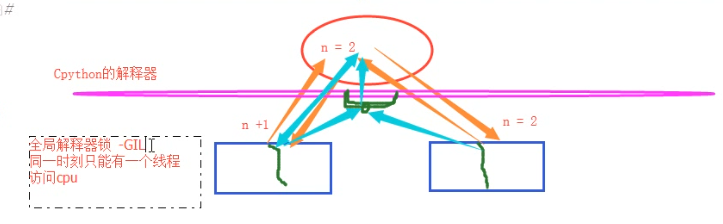
但是有了這個鎖我們就不能併發了嗎?當我們的程式是偏計算的,也就是cpu佔用率很高的程式(cpu一直在計算),就不行了,但是如果你的程式是I/O型的(一般你的程式都是這個)(input、訪問網址網路延遲、開啟/關閉檔案讀寫),在什麼情況下用的到高併發呢(金融計算會用到,人工智慧(阿爾法狗),但是一般的業務場景用不到,爬網頁,多使用者網站、聊天軟體、處理檔案),I/O型的操作很少佔用CPU,那麼多執行緒還是可以併發的,因為cpu只是快速的排程執行緒,而執行緒裡面並沒有什麼計算,就像一堆的網路請求,我cpu非常快速的一個一個的將你的多執行緒排程出去,你的執行緒就去執行I/O操作了,
2.同步鎖
三個需要注意的點:
#1.執行緒搶的是GIL鎖,GIL鎖相當於執行許可權,拿到執行許可權後才能拿到互斥鎖Lock,其他執行緒也可以搶到GIL,但如果發現Lock仍然沒有被釋放則阻塞,即便是拿到執行許可權GIL也要立刻交出來

#2.join是等待所有,即整體序列,而鎖只是鎖住修改共享資料的部分,即部分序列,要想保證資料安全的根本原理在於讓併發變成序列,join與互斥鎖都可以實現,毫無疑問,互斥鎖的部分序列效率要更高

#3. 一定要看本小節最後的GIL與互斥鎖的經典分析
GIL VS Lock

    機智的同學可能會問到這個問題,就是既然你之前說過了,Python已經有一個GIL來保證同一時間只能有一個執行緒來執行了,為什麼這裡還需要lock?

 首先我們需要達成共識:鎖的目的是為了保護共享的資料,同一時間只能有一個執行緒來修改共享的資料

    然後,我們可以得出結論:保護不同的資料就應該加不同的鎖。

 最後,問題就很明朗了,GIL 與Lock是兩把鎖,保護的資料不一樣,前者是直譯器級別的(當然保護的就是直譯器級別的資料,比如垃圾回收的資料),後者是保護使用者自己開發的應用程式的資料,很明顯GIL不負責這件事,只能使用者自定義加鎖處理,即Lock

過程分析:所有執行緒搶的是GIL鎖,或者說所有執行緒搶的是執行許可權

  執行緒1搶到GIL鎖,拿到執行許可權,開始執行,然後加了一把Lock,還沒有執行完畢,即執行緒1還未釋放Lock,有可能執行緒2搶到GIL鎖,開始執行,執行過程中發現Lock還沒有被執行緒1釋放,於是執行緒2進入阻塞,被奪走執行許可權,有可能執行緒1拿到GIL,然後正常執行到釋放Lock。。。這就導致了序列執行的效果

  既然是序列,那我們執行

  t1.start()

  t1.join

  t2.start()

  t2.join()

  這也是序列執行啊,為何還要加Lock呢,需知join是等待t1所有的程式碼執行完,相當於鎖住了t1的所有程式碼,而Lock只是鎖住一部分操作共享資料的程式碼。
詳解:
因為Python直譯器幫你自動定期進行記憶體回收,你可以理解為python直譯器裡有一個獨立的執行緒,每過一段時間它起wake up做一次全域性輪詢看看哪些記憶體資料是可以被清空的,此時你自己的程式 裡的執行緒和 py直譯器自己的執行緒是併發執行的,假設你的執行緒刪除了一個變數,py直譯器的垃圾回收執行緒在清空這個變數的過程中的clearing時刻,可能一個其它執行緒正好又重新給這個還沒來及得清空的記憶體空間賦值了,結果就有可能新賦值的資料被刪除了,為了解決類似的問題,python直譯器簡單粗暴的加了鎖,即當一個執行緒執行時,其它人都不能動,這樣就解決了上述的問題, 這可以說是Python早期版本的遺留問題。
看一段程式碼:解釋為什麼要加鎖,如果下面程式碼中work函式裡面的那個time.sleep(0.005),我的電腦用的這個時間片段,每次執行都呈現不同的結果,我們可以改改時間試一下。
from threading import Thread,Lock
import os,time
def work():
    global n
    # lock.acquire() #加鎖
    temp=n
    time.sleep(0.1) #一會將下面迴圈的資料加大並且這裡的時間改的更小試試
    n=temp-1
    # time.sleep(0.02)
    # n = n - 1
    '''如果這樣寫的話看不出來效果,因為這樣寫就相當於直接將n的指向改了,就好比從10,經過1次減1之後,n就直接指向了9,速度太快,看不出效果,那麼我們怎麼辦呢,找一箇中間變數來接收n,然後對這個中間變數進行修改,然後再賦值給n,多一個給n賦值的過程,那麼在這個過程中間,我們加上一點阻塞時間,來看效果,就像讀檔案修改資料之後再寫回檔案的過程。那麼這個程式就會出現結果為9的情況,首先一個程序的全域性變數對於所有執行緒是共享的,由於我們在程式給中間變數賦值,然後給n再次賦值的過程中我們加了一些I/O時間,遇到I/O就切換,那麼每個執行緒都拿到了10,並對10減1了,然後大家都得到了9,然後再賦值給n,所有n等於了9'''
    # lock.release()
if __name__ == '__main__':
    lock=Lock()
    n=100
    l=[]
    # for i in range(10000):  #如果這裡變成了10000,你在執行一下看看結果
    for i in range(100):  #如果這裡變成了10000,你在執行一下看看結果
        p=Thread(target=work)
        l.append(p)
        p.start()
    for p in l:
        p.join()

    print(n) #結果肯定為0,由原來的併發執行變成序列,犧牲了執行效率保證了資料安全

需要仔細研究的示例
上面這個程式碼示例,如果迴圈次數變成了10000,在我的電腦上就會出現不同的結果,因為線上程切換的那個time.sleep的時間內,有些執行緒還沒有被切換到,也就是有些執行緒還沒有拿到n的值,所以計算結果就沒準了。
鎖通常被用來實現對共享資源的同步訪問。為每一個共享資源建立一個Lock物件,當你需要訪問該資源時,呼叫acquire方法來獲取鎖物件(如果其它執行緒已經獲得了該鎖,則當前執行緒需等待其被釋放),待資源訪問完後,再呼叫release方法釋放鎖:
import threading

R=threading.Lock()

R.acquire() #
#R.acquire()如果這裡還有一個acquire,你會發現,程式就阻塞在這裡了,因為上面的鎖已經被拿到了並且還沒有釋放的情況下,再去拿就阻塞住了
'''
對公共資料的操作
'''
R.release()
通過上面的程式碼示例1,我們看到多個執行緒搶佔資源的情況,可以通過加鎖來解決,看程式碼:
from threading import Thread,Lock
import os,time
def work():
    global n
    lock.acquire() #加鎖
    temp=n
    time.sleep(0.1)
    n=temp-1
    lock.release()
if __name__ == '__main__':
    lock=Lock()
    n=100
    l=[]
    for i in range(100):
        p=Thread(target=work)
        l.append(p)
        p.start()
    for p in l:
        p.join()

    print(n) #結果肯定為0,由原來的併發執行變成序列,犧牲了執行效率保證了資料安全

同步鎖的引用
看上面程式碼的圖形解釋:
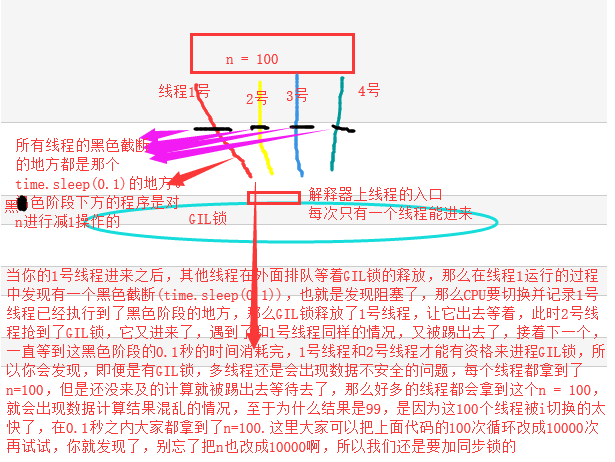
分析:
    #1.100個執行緒去搶GIL鎖,即搶執行許可權
    #2. 肯定有一個執行緒先搶到GIL(暫且稱為執行緒1),然後開始執行,一旦執行就會拿到lock.acquire()
    #3. 極有可能執行緒1還未執行完畢,就有另外一個執行緒2搶到GIL,然後開始執行,但執行緒2發現互斥鎖lock還未被執行緒1釋放,於是阻塞,被迫交出執行許可權,即釋放GIL
    #4.直到執行緒1重新搶到GIL,開始從上次暫停的位置繼續執行,直到正常釋放互斥鎖lock,然後其他的執行緒再重複2 3 4的過程
#不加鎖:併發執行,速度快,資料不安全
from threading import current_thread,Thread,Lock
import os,time
def task():
    global n
    print('%s is running' %current_thread().getName())
    temp=n
    time.sleep(0.5)
    n=temp-1


if __name__ == '__main__':
    n=100
    lock=Lock()
    threads=[]
    start_time=time.time()
    for i in range(100):
        t=Thread(target=task)
        threads.append(t)
        t.start()
    for t in threads:
        t.join()

    stop_time=time.time()
    print('主:%s n:%s' %(stop_time-start_time,n))

'''
Thread-1 is running
Thread-2 is running
......
Thread-100 is running
主:0.5216062068939209 n:99
'''


#不加鎖:未加鎖部分併發執行,加鎖部分序列執行,速度慢,資料安全
from threading import current_thread,Thread,Lock
import os,time
def task():
    #未加鎖的程式碼併發執行
    time.sleep(3)
    print('%s start to run' %current_thread().getName())
    global n
    #加鎖的程式碼序列執行
    lock.acquire()
    temp=n
    time.sleep(0.5)
    n=temp-1
    lock.release()

if __name__ == '__main__':
    n=100
    lock=Lock()
    threads=[]
    start_time=time.time()
    for i in range(100):
        t=Thread(target=task)
        threads.append(t)
        t.start()
    for t in threads:
        t.join()
    stop_time=time.time()
    print('主:%s n:%s' %(stop_time-start_time,n))

'''
Thread-1 is running
Thread-2 is running
......
Thread-100 is running
主:53.294203758239746 n:0
'''

#有的同學可能有疑問:既然加鎖會讓執行變成序列,那麼我在start之後立即使用join,就不用加鎖了啊,也是序列的效果啊
#沒錯:在start之後立刻使用jion,肯定會將100個任務的執行變成序列,毫無疑問,最終n的結果也肯定是0,是安全的,但問題是
#start後立即join:任務內的所有程式碼都是序列執行的,而加鎖,只是加鎖的部分即修改共享資料的部分是序列的
#單從保證資料安全方面,二者都可以實現,但很明顯是加鎖的效率更高.
from threading import current_thread,Thread,Lock
import os,time
def task():
    time.sleep(3)
    print('%s start to run' %current_thread().getName())
    global n
    temp=n
    time.sleep(0.5)
    n=temp-1


if __name__ == '__main__':
    n=100
    lock=Lock()
    start_time=time.time()
    for i in range(100):
        t=Thread(target=task)
        t.start()
        t.join()
    stop_time=time.time()
    print('主:%s n:%s' %(stop_time-start_time,n))

'''
Thread-1 start to run
Thread-2 start to run
......
Thread-100 start to run
主:350.6937336921692 n:0 #耗時是多麼的恐怖
'''

互斥鎖與join的區別(重點)
3.死鎖與遞迴鎖
程序也有死鎖與遞迴鎖,在程序那裡忘記說了,放到這裡一切說了額,程序的死鎖和執行緒的是一樣的,而且一般情況下程序之間是資料不共享的,不需要加鎖,由於執行緒是對全域性的資料共享的,所以對於全域性的資料進行操作的時候,要加鎖。
所謂死鎖: 是指兩個或兩個以上的程序或執行緒在執行過程中,因爭奪資源而造成的一種互相等待的現象,若無外力作用,它們都將無法推進下去。此時稱系統處於死鎖狀態或系統產生了死鎖,這些永遠在互相等待的程序稱為死鎖程序,如下就是死鎖
from threading import Lock as Lock
import time
mutexA=Lock()
mutexA.acquire()
mutexA.acquire()
print(123)
mutexA.release()
mutexA.release()
from threading import Thread,Lock
import time
mutexA=Lock()
mutexB=Lock()

class MyThread(Thread):
    def run(self):
        self.func1()
        self.func2()
    def func1(self):
        mutexA.acquire()
        print('\033[41m%s 拿到A鎖>>>\033[0m' %self.name)
        mutexB.acquire()
        print('\033[42m%s 拿到B鎖>>>\033[0m' %self.name)
        mutexB.release()
        mutexA.release()

    def func2(self):
        mutexB.acquire()
        print('\033[43m%s 拿到B鎖???\033[0m' %self.name)
        time.sleep(2)
        #分析:當執行緒1執行完func1,然後執行到這裡的時候,拿到了B鎖,執行緒2執行func1的時候拿到了A鎖,那麼執行緒2還要繼續執行func1裡面的程式碼,再去拿B鎖的時候,發現B鎖被人拿了,那麼就一直等著別人把B鎖釋放,那麼就一直等著,等到執行緒1的sleep時間用完之後,執行緒1繼續執行func2,需要拿A鎖了,但是A鎖被執行緒2拿著呢,還沒有釋放,因為他在等著B鎖被釋放,那麼這倆人就尷尬了,你拿著我的老A,我拿著你的B,這就尷尬了,倆人就停在了原地

        mutexA.acquire()
        print('\033[44m%s 拿到A鎖???\033[0m' %self.name)
        mutexA.release()

        mutexB.release()

if __name__ == '__main__':
    for i in range(10):
        t=MyThread()
        t.start()

'''
Thread-1 拿到A鎖>>>
Thread-1 拿到B鎖>>>
Thread-1 拿到B鎖???
Thread-2 拿到A鎖>>>
然後就卡住,死鎖了
'''

更難一些的死鎖現象
解決方法,遞迴鎖,在Python中為了支援在同一執行緒中多次請求同一資源,python提供了可重入鎖RLock。
這個RLock內部維護著一個Lock和一個counter變數,counter記錄了acquire的次數,從而使得資源可以被多次require。直到一個執行緒所有的acquire都被release,其他的執行緒才能獲得資源。上面的例子如果使用RLock代替Lock,則不會發生死鎖:
from threading import RLock as Lock
import time
mutexA=Lock()
mutexA.acquire()
mutexA.acquire()
print(123)
mutexA.release()
mutexA.release()
典型問題:科學家吃麵 ,看下面程式碼示例:
import time
from threading import Thread,Lock
noodle_lock = Lock()
fork_lock = Lock()
def eat1(name):
    noodle_lock.acquire()
    print('%s 搶到了麵條'%name)
    fork_lock.acquire()
    print('%s 搶到了叉子'%name)
    print('%s 吃麵'%name)
    fork_lock.release()
    noodle_lock.release()

def eat2(name):
    fork_lock.acquire()
    print('%s 搶到了叉子' % name)
    time.sleep(1)
    noodle_lock.acquire()
    print('%s 搶到了麵條' % name)
    print('%s 吃麵' % name)
    noodle_lock.release()
    fork_lock.release()

for name in ['taibai','egon','wulaoban']:
    t1 = Thread(target=eat1,args=(name,))
    t2 = Thread(target=eat2,args=(name,))
    t1.start()
    t2.start()

和上面更難一些的死鎖現象是一樣的
import time
from threading import Thread,RLock
fork_lock = noodle_lock = RLock()
def eat1(name)