
殘差網路(Residual Network)
一、背景
1)梯度消失問題
我們發現很深的網路層,由於引數初始化一般更靠近0,這樣在訓練的過程中更新淺層網路的引數時,很容易隨著網路的深入而導致梯度消失,淺層的引數無法更新。
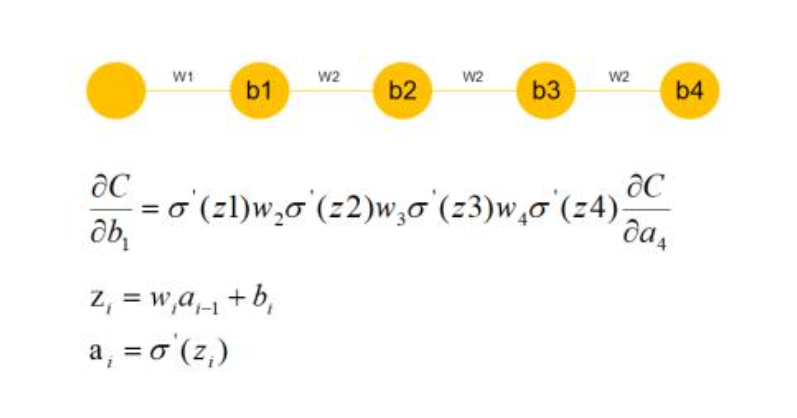
可以看到,假設現在需要更新b1,w2,w3,w4引數因為隨機初始化偏向於0,通過鏈式求導我們會發現,w1w2w3相乘會得到更加接近於0的數,那麼所求的這個b1的梯度就接近於0,也就產生了梯度消失的現象。
2)網路退化問題
舉個例子,假設已經有了一個最優化的網路結構,是18層。當我們設計網路結構的時候,我們並不知道具體多少層次的網路時最優化的網路結構,假設設計了34層網路結構。那麼多出來的16層其實是冗餘的,我們希望訓練網路的過程中,模型能夠自己訓練這五層為恆等對映,也就是經過這層時的輸入與輸出完全一樣。但是往往模型很難將這16層恆等對映的引數學習正確,那麼就一定會不比最優化的18層網路結構效能好,這就是隨著網路深度增加,模型會產生退化現象。它不是由過擬合產生的,而是由冗餘的網路層學習了不是恆等對映的引數造成的。
二、ResNets 殘差網路
ResNet是在2015年有何凱明,張翔宇,任少卿,孫劍共同提出的,ResNet使用了一個新的思想,ResNet的思想是假設我們涉及一個網路層,存在最優化的網路層次,那麼往往我們設計的深層次網路是有很多網路層為冗餘層的。那麼我們希望這些冗餘層能夠完成恆等對映,保證經過該恆等層的輸入和輸出完全相同。具體哪些層是恆等層,這個會有網路訓練的時候自己判斷出來。

可以看到X是這一層殘差塊的輸入,也稱作F(x)為殘差,x為輸入值,F(X)是經過第一層線性變化並激活後的輸出,該圖表示在殘差網路中,第二層進行線性變化之後啟用之前,F(x)加入了這一層輸入值X,然後再進行啟用後輸出。在第二層輸出值啟用前加入X,這條路徑稱作shortcut連線。
三、網路架構
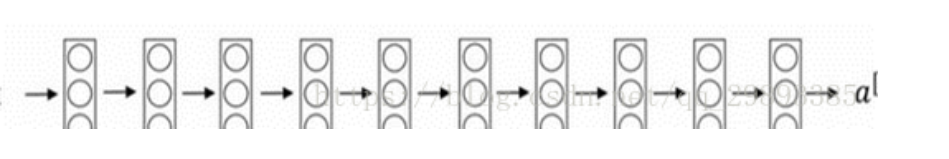
1)普通網路(Plain Network)
2) 殘差網路
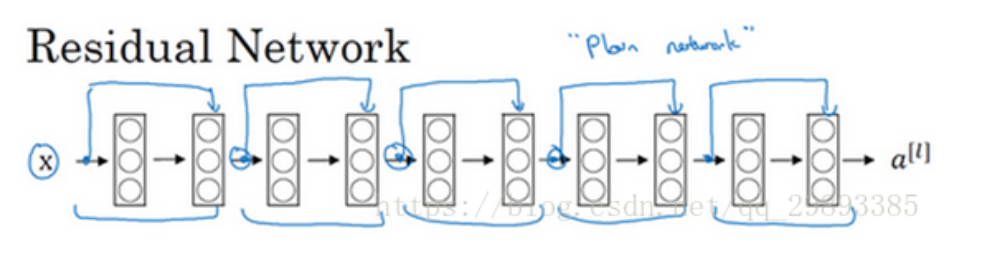
把它變成ResNet的方法是加上所有跳躍連線,每兩層增加一個捷徑,構成一個殘差塊。如圖所示,5個殘差塊連線在一起構成一個殘差網路。
3)對比分析
