
(轉載)堪稱最好的A*演算法
本文版權歸原作者、譯者所有,我只是轉貼;如果侵害到您的權益,請聯絡我,我將刪除本文。
基本上,這文章可以說是最佳A*演算法文件。極力推薦!
Amit’s A star Page中譯文
譯序
這篇文章很適合A*演算法的初學者,可惜網上沒找到翻譯版的。本著好東西不敢獨享的想法,也為了鍛鍊一下英文,本人譯了這篇文章。
由於本人英文水平非常有限,六級考了兩次加一塊不超過370分,因此本譯文難免存在問題。不過也算是拋磚引玉,希望看到有更多的遊戲開發方面的優秀譯作出現,畢竟中文的優秀資料太少了,中國的遊戲開發者的路不好走。
本人能力有限,譯文中有小部分詞句實在難以翻譯,因此暫時保留英文原文放在譯文中。對於不敢確定翻譯是否準確的詞句,本人用圓括號保留了英文原文,讀者可以對照著加以理解。
A*演算法本身是很簡單的,因此原文中並沒有過多地討論A*演算法本身,而是花了較大的篇幅討論了用於儲存OPEN和CLOSED集的資料結構,以及A*演算法的變種和擴充套件。
程式設計實現A*是簡單的,讀者可以用STL對本文中的虛擬碼加以實現(本人已花一天時間實驗過基本的A*搜尋)。但是最重要的還是對A*本身的理解,這樣才可以在自己的遊戲中處理各種千變萬化的情況。
翻譯本文的想法產生於2006年5月,實際完成於2007年4月到6月,非常慚愧。
最後,本譯文僅供交流和參考,對於因本譯文放到網上而產生的任何問題,本人不負任何責任。
蔡鴻於南開大學軟體學院
2007年6月9日
原文地址:http://theory.stanford.edu/~amitp/GameProgramming/
相關連結:http://www-cs-students.stanford.edu/%7Eamitp/gameprog.html#Paths
我們嘗試解決的問題是把一個遊戲物件(game object)從出發點移動到目的地。路徑搜尋(Pathfinding)的目標是找到一條好的路徑——避免障礙物、敵人,並把代價(燃料,時間,距離,裝備,金錢等)最小化。運動(Movement)的目標是找到一條路徑並且沿著它行進。把關注的焦點僅集中於其中的一種方法是可能的。一種極端情況是,當遊戲物件開始移動時,一個老練的路徑搜尋器(pathfinder)外加一個瑣細的運動演算法(movement algorithm)可以找到一條路徑,遊戲物件將會沿著該路徑移動而忽略其它的一切。另一種極端情況是,一個單純的運動系統(movement-only system)將不會搜尋一條路徑(最初的“路徑”將被一條直線取代),取而代之的是在每一個結點處僅採取一個步驟,同時考慮周圍的環境。同時使用路徑搜尋(Pathfinding)和運動演算法(movement algorithm)將會得到最好的效果。
1 導言
移動一個簡單的物體(object)看起來是容易的。而路徑搜尋是複雜的。為什麼涉及到路徑搜尋就產生麻煩了?考慮以下情況:
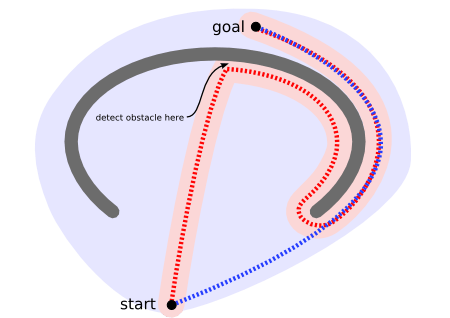
物體(unit)最初位於地圖的底端並且嘗試向頂部移動。物體掃描的區域中(粉紅色部分)沒有任何東西顯示它不能向上移動,因此它持續向上移動。在靠近頂部時,它探測到一個障礙物然後改變移動方向。然後它沿著U形障礙物找到它的紅色的路徑。相反的,一個路徑搜尋器(pathfinder)將會掃描一個更大的區域(淡藍色部分),但是它能做到不讓物體(unit)走向凹形障礙物而找到一條更短的路徑(藍色路徑)。
然而你可以擴充套件一個運動演算法,用於對付上圖所示的障礙物。或者避免製造凹形障礙,或者把凹形出口標識為危險的(只有當目的地在裡面時才進去):
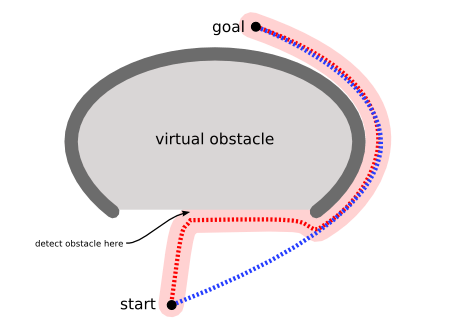
比起一直等到最後一刻才發現問題,路徑搜尋器讓你提前作出計劃。不帶路徑搜尋的運動(movement)可以在很多種情形下工作,同時可以擴充套件到更多的情形,但是路徑搜尋是一種更常用的解決更多問題的方法。
1.1演算法
電腦科學教材中的路徑搜尋演算法在數學視角的圖上工作——由邊聯結起來的結點的集合。一個基於圖塊(tile)拼接的遊戲地圖可以看成是一個圖,每個圖塊(tile)是一個結點,並在每個圖塊之間畫一條邊:
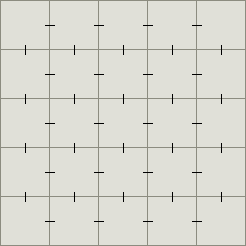
目前,我會假設我們使用二維網格(grid)。稍後我將討論如何在你的遊戲之外建立其他型別的圖。
許多AI領域或演算法研究領域中的路徑搜尋演算法是基於任意(arbitrary)的圖設計的,而不是基於網格(grid-based)的圖。我們可以找到一些能使用網格地圖的特性的東西。有一些我們認為是常識,而演算法並不理解。例如,我們知道一些和方向有關的東西:一般而言,如果兩個物體距離越遠,那麼把其中一個物體向另一個移動將花越多的時間;並且我們知道地圖中沒有任何祕密通道可以從一個地點通向另一個地點。(我假設沒有,如果有的話,將會很難找到一條好的路徑,因為你並不知道要從何處開始。)
1.2 Dijkstra演算法與最佳優先搜尋
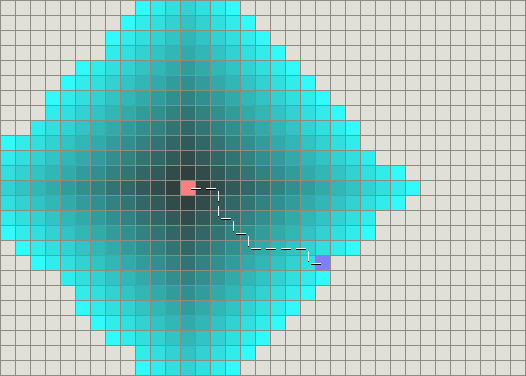
Dijkstra演算法從物體所在的初始點開始,訪問圖中的結點。它迭代檢查待檢查結點集中的結點,並把和該結點最靠近的尚未檢查的結點加入待檢查結點集。該結點集從初始結點向外擴充套件,直到到達目標結點。Dijkstra演算法保證能找到一條從初始點到目標點的最短路徑,只要所有的邊都有一個非負的代價值。(我說“最短路徑”是因為經常會出現許多差不多短的路徑。)在下圖中,粉紅色的結點是初始結點,藍色的是目標點,而類菱形的有色區域(注:原文是teal areas)則是Dijkstra演算法掃描過的區域。顏色最淡的區域是那些離初始點最遠的,因而形成探測過程(exploration)的邊境(frontier):
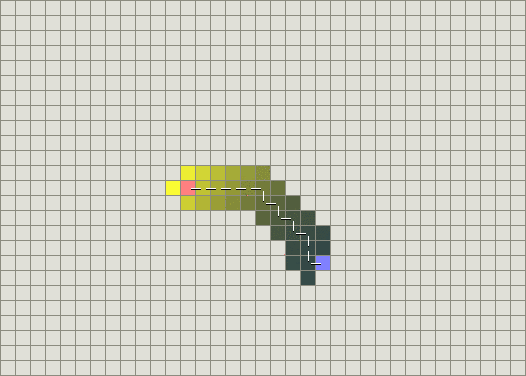
最佳優先搜尋(BFS)演算法按照類似的流程執行,不同的是它能夠評估(稱為啟發式的)任意結點到目標點的代價。與選擇離初始結點最近的結點不同的是,它選擇離目標最近的結點。BFS不能保證找到一條最短路徑。然而,它比Dijkstra演算法快的多,因為它用了一個啟發式函式(heuristic function)快速地導向目標結點。例如,如果目標位於出發點的南方,BFS將趨向於導向南方的路徑。在下面的圖中,越黃的結點代表越高的啟發式值(移動到目標的代價高),而越黑的結點代表越低的啟發式值(移動到目標的代價低)。這表明了與Dijkstra 演算法相比,BFS執行得更快。
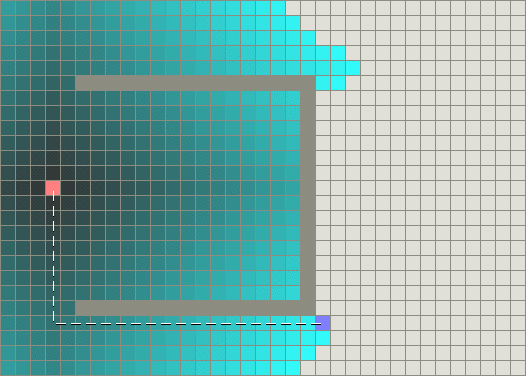
然而,這兩個例子都僅僅是最簡單的情況——地圖中沒有障礙物,最短路徑是直線的。現在我們來考慮前邊描述的凹型障礙物。Dijkstra演算法執行得較慢,但確實能保證找到一條最短路徑:
另一方面,BFS執行得較快,但是它找到的路徑明顯不是一條好的路徑:
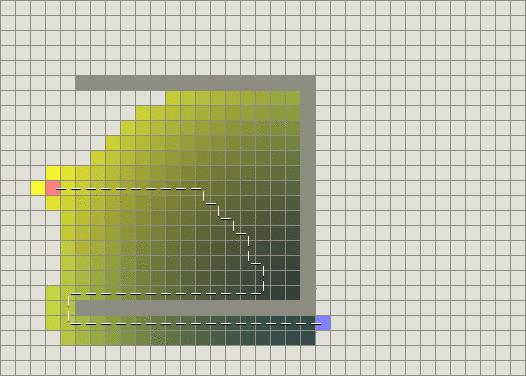
問題在於BFS是基於貪心策略的,它試圖向目標移動儘管這不是正確的路徑。由於它僅僅考慮到達目標的代價,而忽略了當前已花費的代價,於是儘管路徑變得很長,它仍然繼續走下去。
結合兩者的優點不是更好嗎?1968年發明的A*演算法就是把啟發式方法(heuristic approaches)如BFS,和常規方法如Dijsktra演算法結合在一起的演算法。有點不同的是,類似BFS的啟發式方法經常給出一個近似解而不是保證最佳解。然而,儘管A*基於無法保證最佳解的啟發式方法,A*卻能保證找到一條最短路徑。
1.3 A*演算法
我將集中討論A*演算法。A*是路徑搜尋中最受歡迎的選擇,因為它相當靈活,並且能用於多種多樣的情形之中。
和其它的圖搜尋演算法一樣,A*潛在地搜尋圖中一個很大的區域。和Dijkstra一樣,A*能用於搜尋最短路徑。和BFS一樣,A*能用啟發式函式(注:原文為heuristic)引導它自己。在簡單的情況中,它和BFS一樣快。
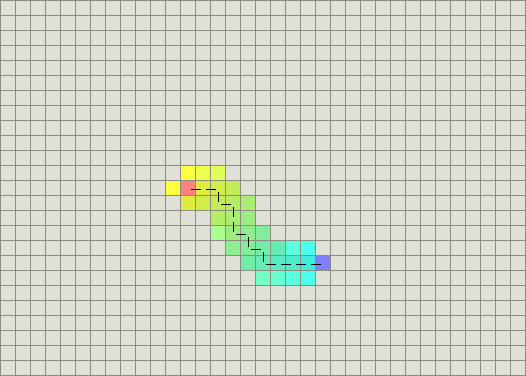
在凹型障礙物的例子中,A*找到一條和Dijkstra演算法一樣好的路徑:
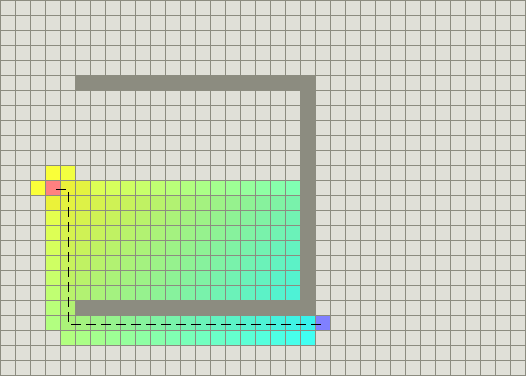
成功的祕決在於,它把Dijkstra演算法(靠近初始點的結點)和BFS演算法(靠近目標點的結點)的資訊塊結合起來。在討論A*的標準術語中,g(n)表示從初始結點到任意結點n的代價,h(n)表示從結點n到目標點的啟發式評估代價(heuristic estimated cost)。在上圖中,yellow(h)表示遠離目標的結點而teal(g)表示遠離初始點的結點。當從初始點向目標點移動時,A*權衡這兩者。每次進行主迴圈時,它檢查f(n)最小的結點n,其中f(n) = g(n) + h(n)。
2 啟發式演算法
啟發式函式h(n)告訴A*從任意結點n到目標結點的最小代價評估值。選擇一個好的啟發式函式是重要的。
2.1 A*對啟發式函式的使用
啟發式函式可以控制A*的行為:
- 一種極端情況,如果h(n)是0,則只有g(n)起作用,此時A*演變成Dijkstra演算法,這保證能找到最短路徑。
- 如果h(n)經常都比從n移動到目標的實際代價小(或者相等),則A*保證能找到一條最短路徑。h(n)越小,A*擴充套件的結點越多,執行就得越慢。
- 如果h(n)精確地等於從n移動到目標的代價,則A*將會僅僅尋找最佳路徑而不擴充套件別的任何結點,這會執行得非常快。儘管這不可能在所有情況下發生,你仍可以在一些特殊情況下讓它們精確地相等(譯者:指讓h(n)精確地等於實際值)。只要提供完美的資訊,A*會執行得很完美,認識這一點很好。
- 如果h(n)有時比從n移動到目標的實際代價高,則A*不能保證找到一條最短路徑,但它執行得更快。
- 另一種極端情況,如果h(n)比g(n)大很多,則只有h(n)起作用,A*演變成BFS演算法。
所以我們得到一個很有趣的情況,那就是我們可以決定我們想要從A*中獲得什麼。理想情況下(注:原文為At exactly the right point),我們想最快地得到最短路徑。如果我們的目標太低,我們仍會得到最短路徑,不過速度變慢了;如果我們的目標太高,那我們就放棄了最短路徑,但A*執行得更快。
在遊戲中,A*的這個特性非常有用。例如,你會發現在某些情況下,你希望得到一條好的路徑(“good” path)而不是一條完美的路徑(“perfect” path)。為了權衡g(n)和h(n),你可以修改任意一個。
注:在學術上,如果啟發式函式值是對實際代價的低估,A*演算法被稱為簡單的A演算法(原文為simply A)。然而,我繼續稱之為A*,因為在實現上是一樣的,並且在遊戲程式設計領域並不區別A和A*。
2.2速度還是精確度?
A*改變它自己行為的能力基於啟發式代價函式,啟發式函式在遊戲中非常有用。在速度和精確度之間取得折衷將會讓你的遊戲執行得更快。在很多遊戲中,你並不真正需要得到最好的路徑,僅需要近似的就足夠了。而你需要什麼則取決於遊戲中發生著什麼,或者運行遊戲的機器有多快。
假設你的遊戲有兩種地形,平原和山地,在平原中的移動代價是1而在山地則是3。A* is going to search three times as far along flat land as it does along mountainous land.這是因為有可能有一條沿著平原到山地的路徑。把兩個鄰接點之間的評估距離設為1.5可以加速A*的搜尋過程。然後A*會將3和1.5比較,這並不比把3和1比較差。It is not as dissatisfied with mountainous terrain, so it won’t spend as much time trying to find a way around it. Alternatively, you can speed up up A*’s search by decreasing the amount it searches for paths around mountains―just tell A* that the movement cost on mountains is 2 instead of 3. Now it will search only twice as far along the flat terrain as along mountainous terrain. Either approach gives up ideal paths to get something quicker.
速度和精確度之間的選擇前不是靜態的。你可以基於CPU的速度、用於路徑搜尋的時間片數、地圖上物體(units)的數量、物體的重要性、組(group)的大小、難度或者其他任何因素來進行動態的選擇。取得動態的折衷的一個方法是,建立一個啟發式函式用於假定通過一個網格空間的最小代價是1,然後建立一個代價函式(cost function)用於測量(scales):
g’(n) = 1 + alpha * ( g(n) – 1 )
如果alpha是0,則改進後的代價函式的值總是1。這種情況下,地形代價被完全忽略,A*工作變成簡單地判斷一個網格可否通過。如果alpha是1,則最初的代價函式將起作用,然後你得到了A*的所有優點。你可以設定alpha的值為0到1的任意值。
你也可以考慮對啟發式函式的返回值做選擇:絕對最小代價或者期望最小代價。例如,如果你的地圖大部分地形是代價為2的草地,其它一些地方是代價為1的道路,那麼你可以考慮讓啟發式函式不考慮道路,而只返回2*距離。
速度和精確度之間的選擇並不是全域性的。在地圖上的某些區域,精確度是重要的,你可以基於此進行動態選擇。例如,假設我們可能在某點停止重新計算路徑或者改變方向,則在接近當前位置的地方,選擇一條好的路徑則是更重要的,因此為何要對後續路徑的精確度感到厭煩?或者,對於在地圖上的一個安全區域,最短路徑也許並不十分重要,但是當從一個敵人的村莊逃跑時,安全和速度是最重要的。(譯者注:譯者認為這裡指的是,在安全區域,可以考慮不尋找精確的最短路徑而取近似路徑,因此尋路快;但在危險區域,逃跑的安全性和逃跑速度是重要的,即路徑的精確度是重要的,因此可以多花點時間用於尋找精確路徑。)
2.3衡量單位
A*計算f(n) = g(n) + h(n)。為了對這兩個值進行相加,這兩個值必須使用相同的衡量單位。如果g(n)用小時來衡量而h(n)用米來衡量,那麼A*將會認為g或者h太大或者太小,因而你將不能得到正確的路徑,同時你的A*演算法將執行得更慢。
2.4精確的啟發式函式
如果你的啟發式函式精確地等於實際最佳路徑(optimal path),如下一部分的圖中所示,你會看到此時A*擴充套件的結點將非常少。A*演算法內部發生的事情是:在每一結點它都計算f(n) = g(n) + h(n)。當h(n)精確地和g(n)匹配(譯者注:原文為match)時,f(n)的值在沿著該路徑時將不會改變。不在正確路徑(right path)上的所有結點的f值均大於正確路徑上的f值(譯者注:正確路徑在這裡應該是指最短路徑)。如果已經有較低f值的結點,A*將不考慮f值較高的結點,因此它肯定不會偏離最短路徑。
2.4.1 預計算的精確啟發式函式
構造精確啟發函式的一種方法是預先計算任意一對結點之間最短路徑的長度。在許多遊戲的地圖中這並不可行。然後,有幾種方法可以近似模擬這種啟發函式:
- Fit a coarse grid on top of the fine grid. Precompute the shortest path between any pair of coarse grid locations.
- Precompute the shortest path between any pair of waypoints. This is a generalization of the coarse grid approach.
(譯者:此處不好翻譯,暫時保留原文)
然後新增一個啟發函式h’用於評估從任意位置到達鄰近導航點(waypoints)的代價。(如果願意,後者也可以通過預計算得到。)最終的啟發式函式可以是:
h(n) = h’(n, w1) + distance(w1, w2), h’(w2, goal)
或者如果你希望一個更好但是更昂貴的啟發式函式,則分別用靠近結點和目標的所有的w1,w2對對上式進行求值。(譯者注:原文為or if you want a better but more expensive heuristic, evaluate the above with all pairs w1, w2 that are close to the node and the goal, respectively.)
2.4.2 線性精確啟發式演算法
在特殊情況下,你可以不通過預計算而讓啟發式函式很精確。如果你有一個不存在障礙物和slow地形,那麼從初始點到目標的最短路徑應該是一條直線。
如果你正使用簡單的啟發式函式(我們不知道地圖上的障礙物),則它應該和精確的啟發式函式相符合(譯者注:原文為match)。如果不是這樣,則你會遇到衡量單位的問題,或者你所選擇的啟發函式型別的問題。
2.5網格地圖中的啟發式演算法
在網格地圖中,有一些眾所周知的啟發式函式。
2.5.1 曼哈頓距離
標準的啟發式函式是曼哈頓距離(Manhattan distance)。考慮你的代價函式並找到從一個位置移動到鄰近位置的最小代價D。因此,我的遊戲中的啟發式函式應該是曼哈頓距離的D倍:
H(n) = D * (abs ( n.x – goal.x ) + abs ( n.y – goal.y ) )
你應該使用符合你的代價函式的衡量單位。
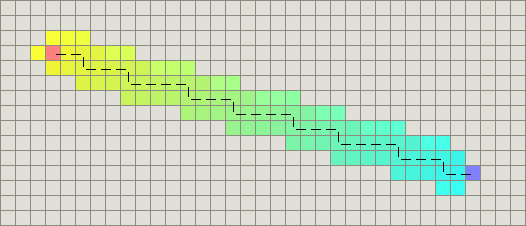
(Note: the above image has a tie-breaker added to the heuristic.}
(譯者注:曼哈頓距離——兩點在南北方向上的距離加上在東西方向上的距離,即D(I,J)=|XI-XJ|+|YI-YJ|。對於一個具有正南正北、正東正西方向規則佈局的城鎮街道,從一點到達另一點的距離正是在南北方向上旅行的距離加上在東西方向上旅行的距離因此曼哈頓距離又稱為計程車距離,曼哈頓距離不是距離不變數,當座標軸變動時,點間的距離就會不同——百度知道)
2.5.2 對角線距離
如果在你的地圖中你允許對角運動那麼你需要一個不同的啟發函式。(4 east, 4 north)的曼哈頓距離將變成8*D。然而,你可以簡單地移動(4 northeast)代替,所以啟發函式應該是4*D。這個函式使用對角線,假設直線和對角線的代價都是D:
h(n) = D * max(abs(n.x - goal.x), abs(n.y - goal.y))
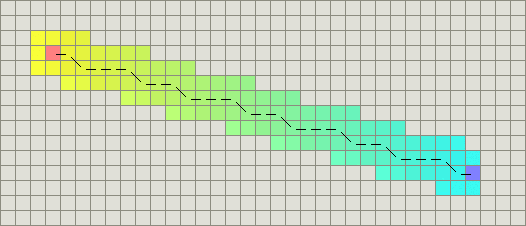
如果對角線運動的代價不是D,但類似於D2 = sqrt(2) * D,則上面的啟發函式不準確。你需要一些更準確(原文為sophisticated)的東西:
h_diagonal(n) = min(abs(n.x - goal.x), abs(n.y - goal.y))
h_straight(n) = (abs(n.x - goal.x) + abs(n.y - goal.y))
h(n) = D2 * h_diagonal(n) + D * (h_straight(n) - 2*h_diagonal(n)))
這裡,我們計算h_diagonal(n):沿著斜線可以移動的步數;h_straight(n):曼哈頓距離;然後合併這兩項,讓所有的斜線步都乘以D2,剩下的所有直線步(注意這裡是曼哈頓距離的步數減去2倍的斜線步數)都乘以D。
2.5.3 歐幾里得距離
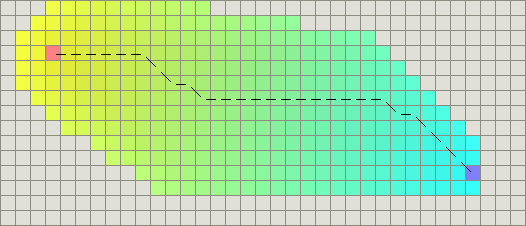
如果你的單位可以沿著任意角度移動(而不是網格方向),那麼你也許應該使用直線距離:
h(n) = D * sqrt((n.x-goal.x)^2 + (n.y-goal.y)^2)
然而,如果是這樣的話,直接使用A*時將會遇到麻煩,因為代價函式g不會match啟發函式h。因為歐幾裡得距離比曼哈頓距離和對角線距離都短,你仍可以得到最短路徑,不過A*將執行得更久一些:
2.5.4 平方後的歐幾里得距離
我曾經看到一些A*的網頁,其中提到讓你通過使用距離的平方而避免歐幾裡得距離中昂貴的平方根運算:
h(n) = D * ((n.x-goal.x)^2 + (n.y-goal.y)^2)
不要這樣做!這明顯地導致衡量單位的問題。當A*計算f(n) = g(n) + h(n),距離的平方將比g的代價大很多,並且你會因為啟發式函式評估值過高而停止。對於更長的距離,這樣做會靠近g(n)的極端情況而不再計算任何東西,A*退化成BFS:
導致低效能的一個原因來自於啟發函式的ties(注:這個詞實在不知道應該翻譯為什麼)。當某些路徑具有相同的f值的時候,它們都會被搜尋(explored),儘管我們只需要搜尋其中的一條:
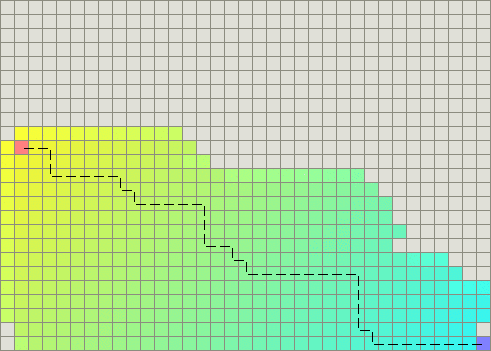
Ties in f values.
為了解決這個問題,我們可以為啟發函式新增一個附加值(譯者注:原文為small tie breaker)。附加值對於結點必須是確定性的(也就是說,不能是隨機的數),而且它必須讓f值體現區別。因為A*對f值排序,讓f值不同意味著只有一個“equivalent”的f值會被檢測。
一種新增附加值的方式是稍微改變(譯者注:原文為nudge)h的衡量單位。如果我們減少衡量單位(譯者注:原文為scale it downwards),那麼當我們朝著目標移動的時候f將逐漸增加。很不幸,這意味著A*傾向於擴充套件到靠近初始點的結點,而不是靠近目標的結點。我們可以增加衡量單位(譯者注:原文為scale it downwards scale h upwards slightly)(甚至是0.1%),A*就會傾向於擴充套件到靠近目標的結點。
heuristic *= (1.0 + p)
選擇因子p使得p < 移動一步(step)的最小代價 / 期望的最長路徑長度。假設你不希望你的路徑超過1000步(step),你可以使p = 1 / 1000。新增這個附加值的結果是,A*比以前搜尋的結點更少了。
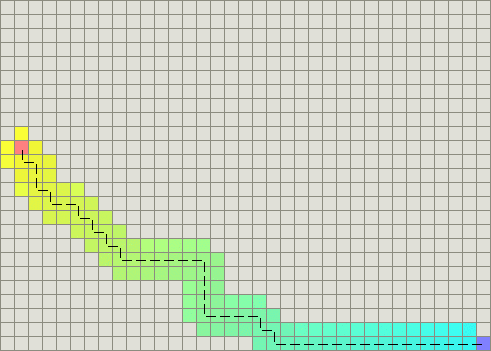
Tie-breaking scaling added to heuristic.
當存在障礙物時,當然仍要在它們周圍尋找路徑,但要意識到,當繞過障礙物以後,A*搜尋的區域非常少:
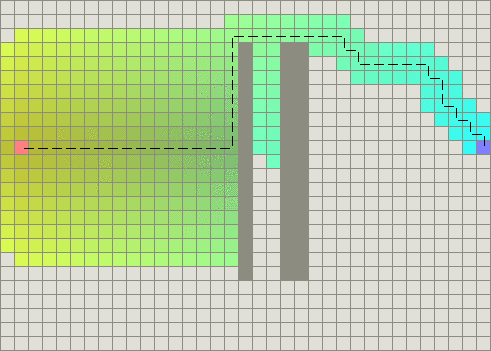
Tie-breaking scaling added to heuristic, works nicely with obstacles.
Steven van Dijk建議,一個更直截了當的方法是把h傳遞到比較函式(comparison function)。當f值相等時,比較函式檢查h,然後新增附加值。
一個不同的新增附加值的方法是,傾向於從初始點到目標點的連線(直線):
dx1 = current.x - goal.x
dy1 = current.y - goal.y
dx2 = start.x - goal.x
dy2 = start.y - goal.y
cross = abs(dx1*dy2 - dx2*dy1)
heuristic += cross*0.001
這段程式碼計算初始-目標向量(start to goal vector)和當前-目標向量(current point to goal vector)的向量叉積(vector cross-product)。When these vectors don’t line up, the cross product will be larger.結果是,這段程式碼選擇的路徑稍微傾向於從初始點到目標點的直線。當沒有障礙物時,A*不僅搜尋很少的區域,而且它找到的路徑看起來非常棒:
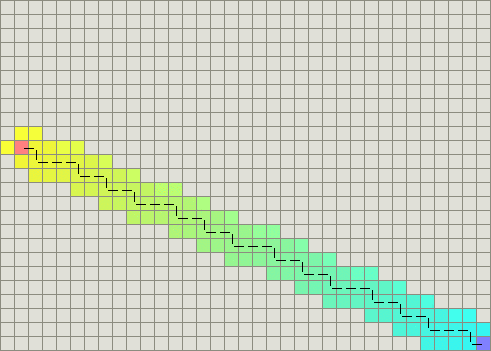
Tie-breaking cross-product added to heuristic, produces pretty paths.
然而,因為這種附加值傾向於從初始點到目標點的直線路徑,當出現障礙物時將會出現奇怪的結果(注意這條路徑仍是最佳的,只是看起來很奇怪):
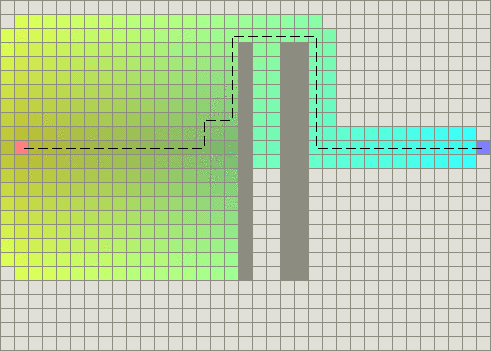
Tie-breaking cross-product added to heuristic, less pretty with obstacles.
為了互動地研究這種附加值方法的改進,請參考James Macgill的A*確applet(http://www.ccg.leeds.ac.uk/james/aStar/ )[如果連結無效,請使用這個映象(http://www.vision.ee.ethz.ch/~buc/astar/AStar.html)](譯者注:兩個連結均無效)。使用“Clear”以清除地圖,選擇地圖對角的兩個點。當你使用“Classic A*”方法,你會看到附加值的效果。當你使用“Fudge”方法,你會看到上面給啟發函式新增叉積後的效果。
然而另一種新增附加值的方法是,小心地構造你的A*優先佇列,使新插入的具有特殊f值的結點總是比那些以前插入的具有相同f值的舊結點要好一些。
你也許也想看看能夠更靈活地(譯者注:原文為sophisticated)新增附加值的AlphA*演算法(http://home1.stofanet.dk/breese/papers.html),不過用這種演算法得到的路徑是否能達到最佳仍在研究中。AlphA*具有較好的適應性,而且可能比我在上面討論的附加值方法執行得都要好。然而,我所討論的附加值方法非常容易實現,所以從它們開始吧,如果你需要得到更好的效果,再去嘗試AlphA*。
2.5.6 區域搜尋
如果你想搜尋鄰近目標的任意不確定結點,而不是某個特定的結點,你應該建立一個啟發函式h’(x),使得h’(x)為h1(x), h2(x), h3(x)。。。的最小值,而這些h1, h2, h3是鄰近結點的啟發函式。然而,一種更快的方法是讓A*僅搜尋目標區域的中心。一旦你從OPEN集合中取得任意一個鄰近目標的結點,你就可以停止搜尋並建立一條路徑了。
3.1 概略
如果不考慮具體實現程式碼,A*演算法是相當簡單的。有兩個集合,OPEN集和CLOSED集。其中OPEN集儲存待考查的結點。開始時,OPEN集只包含一個元素:初始結點。CLOSED集儲存已考查過的結點。開始時,CLOSED集是空的。如果繪成圖,OPEN集就是被訪問區域的邊境(frontier)而CLOSED集則是被訪問區域的內部(interior)。每個結點同時儲存其父結點的指標因此我們可以知道它是如何被找到的。
在主迴圈中重複地從OPEN集中取出最好的結點n(f值最小的結點)並檢查之。如果n是目標結點,則我們的任務完成了。否則,結點n被從OPEN集中刪除並加入CLOSED集。然後檢查它的鄰居n’。如果鄰居n’在CLOSED集中,那麼它是已經被檢查過的,所以我們不需要考慮它*;如果n’在OPEN集中,那麼它是以後肯定會被檢查的,所以我們現在不考慮它*。否則,把它加入OPEN集,把它的父結點設為n。到達n’的路徑的代價g(n’),設定為g(n) + movementcost(n, n’)。
(*)這裡我忽略了一個小細節。你確實需要檢查結點的g值是否更小了,如果是的話,需要重新開啟(re-open)它。
OPEN = priority queue containing START
CLOSED = empty set
while lowest rank in OPEN is not the GOAL:
current = remove lowest rank item from OPEN
add current to CLOSED
for neighbors of current:
cost = g(current) + movementcost(current, neighbor)
if neighbor in OPEN and cost less than g(neighbor):
remove neighbor from OPEN, because new path is better
if neighbor in CLOSED and cost less than g(neighbor): **
remove neighbor from CLOSED
if neighbor not in OPEN and neighbor not in CLOSED:
set g(neighbor) to cost
add neighbor to OPEN
set priority queue rank to g(neighbor) + h(neighbor)
set neighbor’s parent to current
reconstruct reverse path from goal to start
by following parent pointers
(**) This should never happen if you have an admissible heuristic. However in games we often have inadmissible heuristics.
3.2 原始碼
我自己的(舊的)C++A*程式碼是可用的:path.cpp (http://theory.stanford.edu/~amitp/ GameProgramming/path.cpp)和path.h (http://theory.stanford.edu/~amitp/GameProgramming/ path.h),但是不容易閱讀。還有一份更老的程式碼(更慢的,但是更容易理解),和很多其它的A*實現一樣,它在Steve Woodcock’的遊戲AI頁面()。
在網上,你能找到C,C++,Visual Basic ,Java(http://www.cuspy.com/software/pathfinder/ doc/),和實現的A*程式碼。一定的閱讀Justin Heyes-Jones的C++實現()。
3.3 集合的表示
你首先想到的用於實現OPEN集和CLOSED集的資料結構是什麼?如果你和我一樣,你可能想到“陣列”。你也可能想到“連結串列”。我們可以使用很多種不同的資料結構,為了選擇一種,我們應該考慮我們需要什麼樣的操作。
在OPEN集上我們主要有三種操作:主迴圈重複選擇最好的結點並刪除它;訪問鄰居結點時需要檢查它是否在集合裡面;訪問鄰居結點時需要插入新結點。插入和刪除最佳是優先佇列(http://members.xoom.com/killough/heaps.html)的典型操作。
選擇哪種資料結構不僅取決於操作,還取決於每種操作執行的次數。檢查一個結點是否在集合中這一操作對每個被訪問的結點的每個鄰居結點都執行一次。刪除最佳操作對每個被訪問的結點都執行一次。被考慮到的絕大多數結點都會被訪問;不被訪問的是搜尋空間邊緣(fringe)的結點。當評估資料結構上面的這些操作時,必須考慮fringe(F)的最大值。
另外,還有第四種操作,雖然執行的次數相對很少,但還是必須實現的。如果正被檢查的結點已經在OPEN集中(這經常發生),並且如果它的f值比已經在OPEN集中的結點要好(這很少見),那麼OPEN集中的值必須被調整。調整操作包括刪除結點(f值不是最佳的結點)和重插入。這兩個步驟必須被最優化為一個步驟,這個步驟將移動結點。
3.3.1 未排序陣列或連結串列
最簡單的資料結構是未排序陣列或連結串列。集合關係檢查操作(Membership test)很慢,掃描整個結構花費O(F)。插入操作很快,新增到末尾花費O(1)。查詢最佳元素(Finding the best element)很慢,掃描整個結構花費O(F)。對於陣列,刪除最佳元素(Removing the best element)花費O(F),而連結串列則是O(1)。調整操作中,查詢結點花費O(F),改變值花費O(1)。
3.3.2 排序陣列
為了加快刪除最掛操作,可以對陣列進行排序。集合關係檢查操作將變成O(log F),因為我們可以使用折半查詢。插入操作會很慢,為了給新元素騰出空間,需要花費 O(F)以移動所有的元素。查詢最佳元素操作會很快,因為它已經在末尾了所以花費是O(1)。如果我們保證最佳排序至陣列的尾部(best sorts to the end of the array),刪除最佳元素操作花費將是O(1)。調整操作中,查詢結點花費O(logF),改變值/位置花費O(F)。
3.3.3 排序連結串列
在排序陣列中,插入操作很慢。如果使用連結串列則可以加速該操作。集合關係檢查操作很慢,需要花費O(F)用於掃描連結串列。插入操作是很快的,插入新元素只花費O(1)時間,但是查詢正確位置需要花費O(F)。查詢最佳元素很快,花費O(1)時間,因為最佳元素已經在表的尾部。刪除最佳元素也是O(1)。調整操作中,查詢結點花費O(F),改變值/位置花費O(1)。
3.3.4 排序跳錶
在未排序連結串列中查詢元素是很慢的。如果用跳錶(http://en.wikipedia.org/wiki/Skip_list)代替連結串列的話,可以加速這個操作。在跳錶中,如果有排序鍵(sort key)的話,集合關係檢查操作會很快:O(log F)。如果你知道在何處插入的話,和連結串列一樣,插入操作也是O(1)。如果排序鍵是f,查詢最佳元素很快,達到O(1),刪除一個元素也是O(1)。調整操作涉及到查詢結點,刪除結點和重插入。
如果我們用地圖位置作為跳錶的排序鍵,集合關係檢查操作將是O(log F)。在完成集合關係檢查後,插入操作是O(1)。查詢最佳元素是O(F),刪除一個結點是O(1)。因為集合關係檢查更快,所以它比未排序連結串列要好一些。
如果我們用f值作為跳錶的排序鍵,集合關係檢查操作將是O(F)。插入操作是O(1)。查詢最佳元素是O(1),刪除一個結點是O(1)。這並不比排序連結串列好。
3.3.5 索引陣列
如果結點的集合有限並且數目是適當的,我們可以使用直接索引結構,索引函式i(n)把結點n對映到一個數組的索引。未排序與排序陣列的長度等於OPEN集的最大值,和它們不同,對所有的n,索引陣列的長度總是等於max(i(n))。如果你的函式是密集的(沒有不被使用的索引),max(i(n))將是你地圖中結點的數目。只要你的地圖是網格的,讓索引函式密集就是容易的。
假設i(n)是O(1)的,集合關係檢查將花費O(1),因為我們幾乎不需要檢查Array[i(n)]是否包含任何資料。Insertion is O(1), as we just ste Array[i(n)].查詢和刪除最佳操作是O(numnodes),因為我們必須搜尋整個結構。調整操作是O(1)。
3.3.6 雜湊表
索引陣列使用了很多記憶體用於儲存不在OPEN集中的所有結點。一個選擇是使用雜湊表。雜湊表使用了一個雜湊函式h(n)把地圖上每個結點對映到一個雜湊碼。讓雜湊表的大小等於N的兩倍,以使發生衝突的可能性降低。假設h(n)是O(1)的,集體關係檢查操作花費O(1);插入操作花費O(1);刪除最佳元素操作花費O(numnodes),因為我們需要搜尋整個結構。調整操作花費O(1)。
3.3.7 二元堆
一個二元堆(不要和記憶體堆混淆)是一種儲存在陣列中的樹結構。和許多普通的樹通過指標指向子結點所不同,二元堆使用索引來查詢子結點。C++ STL包含了一個二元堆的高效實現,我在我自己的A*程式碼中使用了它。
在二元堆中,集體關係檢查花費O(F),因為你必須掃描整個結構。插入操作花費O(log F)而刪除最佳操作花費也是O(log F)。調整操作很微妙(tricky),花費O(F)時間找到節點,並且很神奇,只用O(log F)來調整。
我的一個朋友(他研究用於最短路徑演算法的資料結構)說,除非在你的fringe集裡有多於10000個元素,否則二元堆是很不錯的。除非你的遊戲地圖特別大,否則你不需要更復雜的資料結構(如())。你應該儘可能不用Fibonacci 堆(http://www.star-lab.com/goldberg/pub/neci-tr-96-062.ps),因為雖然它的漸近複雜度很好,但是執行起來很慢,除非F足夠大。
3.3.8 伸展樹
堆是一種基於樹的結構,它有一個期望